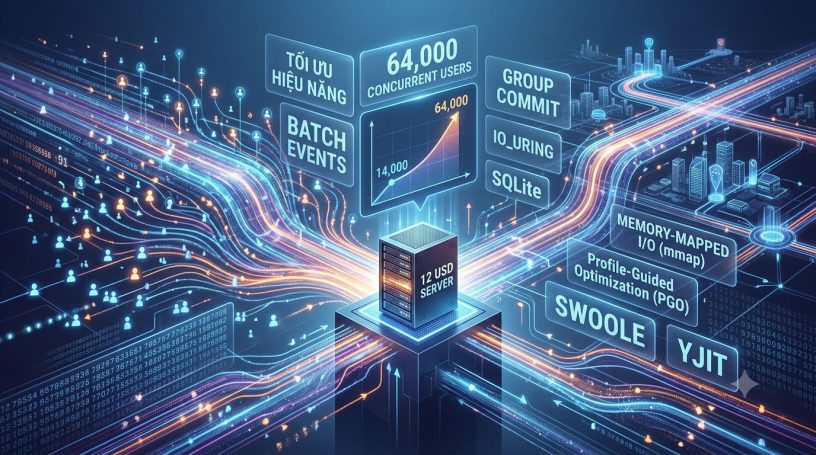
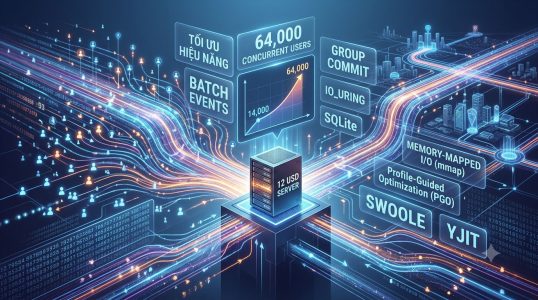
Mình vừa xem một video khá thú vị của Arjay McCandless về System Design và Performance Optimization, video đó là: I Asked Expert Programmers to Max Out a $12 Server. Điều khiến mình ấn tượng không chỉ là con số 64,000 concurrent users trên một chiếc server giá 12 USD/tháng, mà còn là cách các lập trình viên tối ưu hệ thống bằng việc hiểu sâu hơn về database, bộ nhớ, hệ điều hành và cách ứng dụng xử lý request.
Câu chuyện này cũng khiến mình suy nghĩ lại về một điều: Đôi khi, để hệ thống chạy nhanh hơn, chúng ta không cần một chiếc server mạnh hơn hay một ngôn ngữ lập trình mới. Điều cần làm có thể là loại bỏ những chi phí không thực sự cần thiết trong kiến trúc hiện tại.
Mục lục
Một chiếc server 12 USD và thử thách tưởng chừng đơn giản
Ban đầu, tác giả thực hiện benchmark 8 ngôn ngữ lập trình trên một máy ảo có cấu hình khá khiêm tốn:
- 1 shared vCPU
- 2 GB RAM
- 50 GB dung lượng lưu trữ
- Chi phí khoảng 12 USD/tháng
Với cấu hình mặc định, ứng dụng sử dụng web framework phổ biến, PostgreSQL và Nginx. Kết quả tốt nhất ban đầu thuộc về Rust kết hợp với SQLite, đạt khoảng 14,050 concurrent users. Nhiều lập trình viên cho rằng kết quả này vẫn còn có thể cải thiện đáng kể. Tác giả quyết định mở một repository trên GitHub và mời cộng đồng cùng tham gia tối ưu: twelve-dollar-server-challenge.
Đề bài là xây dựng một Social Media API đơn giản, tương tự Twitter, với năm chức năng: Kiểm tra trạng thái hệ thống, tải feed, xem bài viết, like bài viết và tạo bài viết mới. Điều thú vị nằm ở những giới hạn mà mọi người phải tuân thủ:
- Tất cả các bản triển khai đều phải sử dụng SQLite chạy trực tiếp trong process của ứng dụng. Không được dùng PostgreSQL, Redis hay một dịch vụ cache bên ngoài. Không được lách luật bằng cách lưu dữ liệu vào một cấu trúc in-memory riêng.
- Phải vượt qua bộ test suite gồm 42 bài kiểm tra và trả về định dạng response khớp tuyệt đối với đặc tả.
- Mọi request có xác thực đều phải verify chữ ký của login token.
- Đặc biệt, những thao tác ghi dữ liệu (Tạo bài viết, Like) phải commit thành công xuống database trước khi trả kết quả cho người dùng.
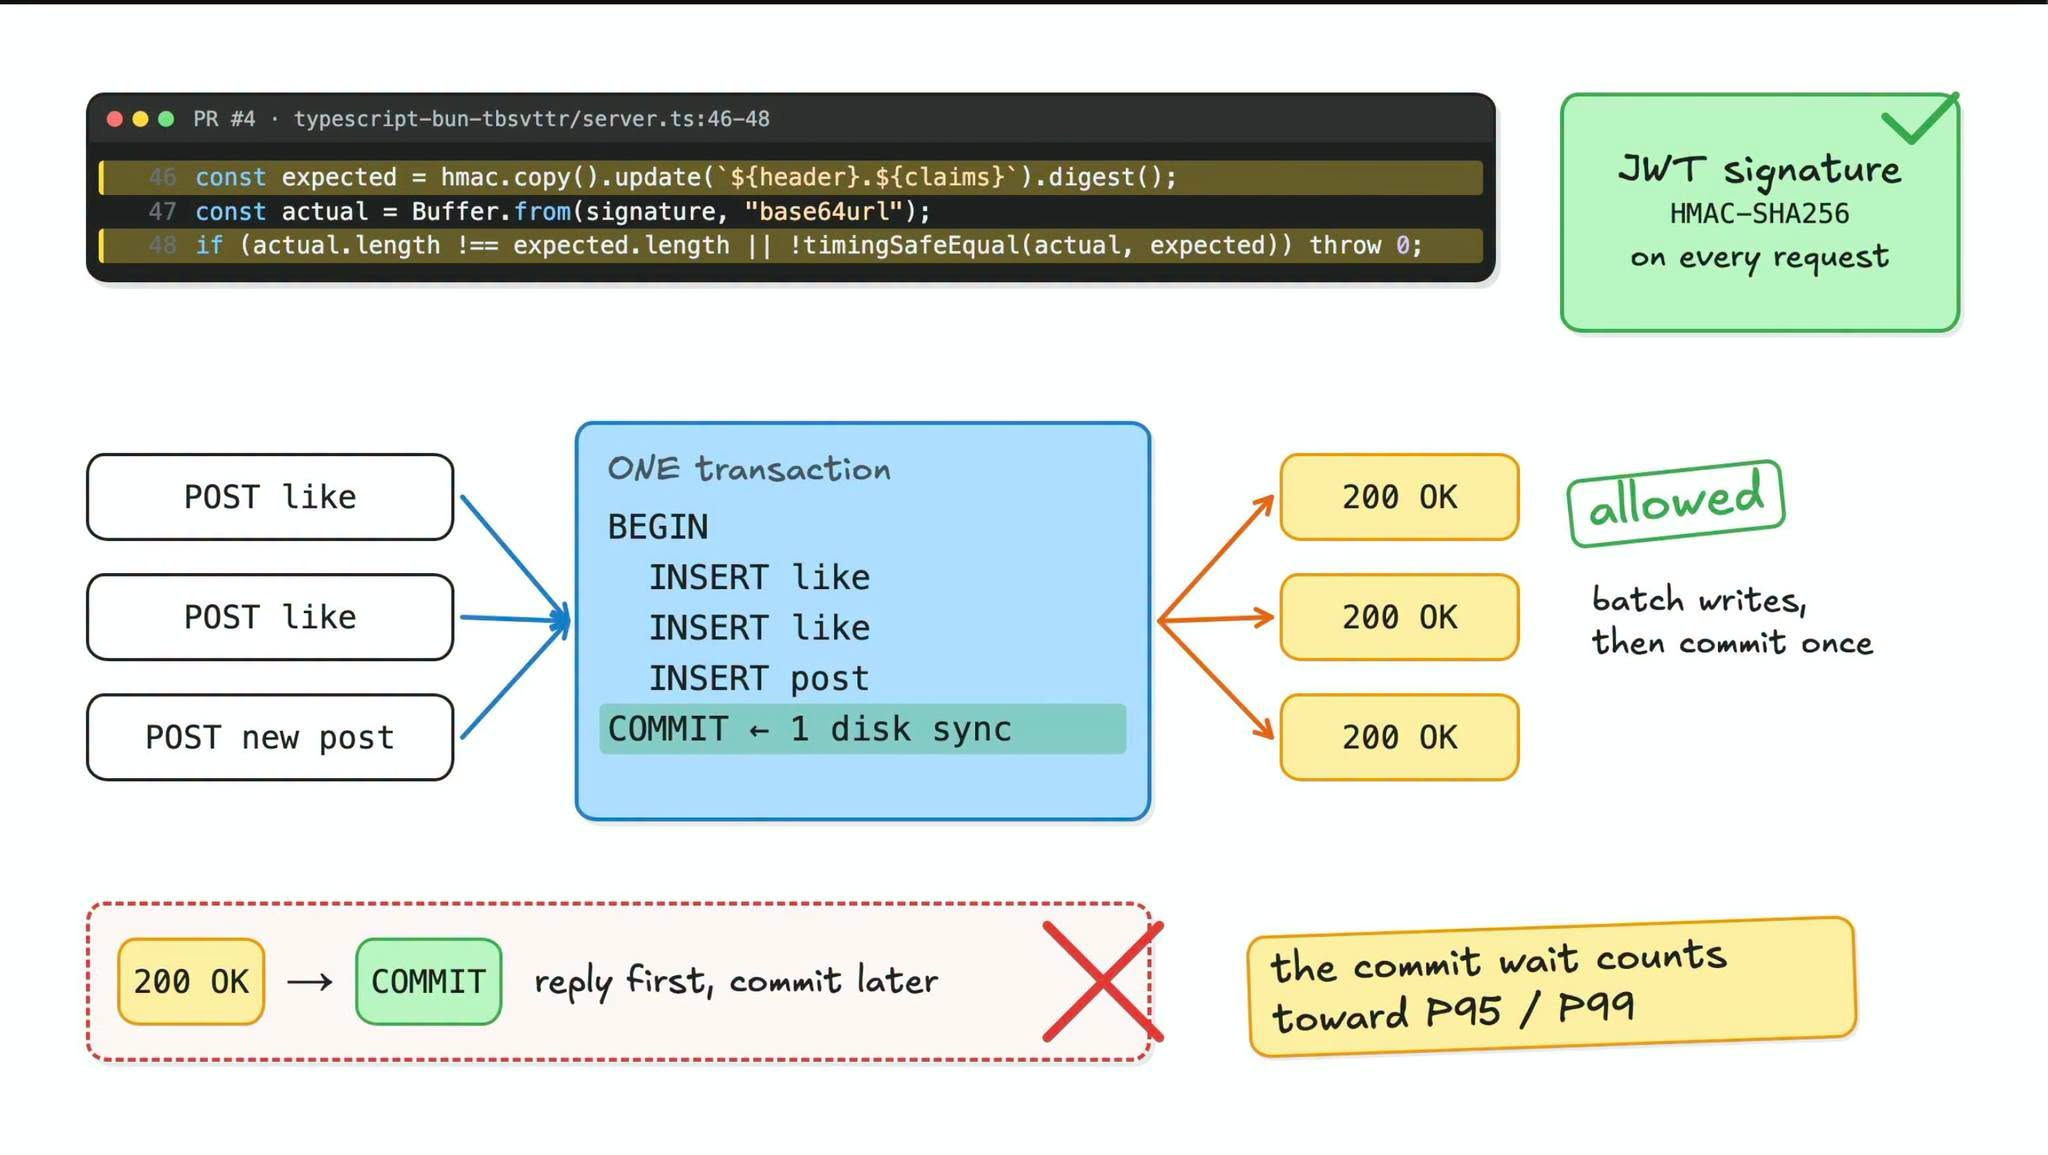
Nói cách khác, đây không phải cuộc thi xem ai có thể trả về response nhanh nhất bằng mọi giá. Hệ thống vẫn phải đáp ứng các yêu cầu chức năng và tính đúng đắn của dữ liệu. Bộ kiểm thử sử dụng k6 để mô phỏng hành vi người dùng thực tế. Mỗi cấp độ tải phải được duy trì liên tục trong năm phút, với p95 latency dưới 500 ms, p99 dưới một giây và tỷ lệ lỗi dưới 1%.
Có tổng cộng 28 bài dự thi đến từ 13 ngôn ngữ, trong đó 26 bài hợp lệ được đưa vào benchmark, và không có bài nào từ đội Java và NodeJs. Một chi tiết khá hài hước là các ứng dụng chạy nhanh đến mức chính chiếc máy ảo dùng để tạo tải lại bị quá tải RAM trước cả con server 12$. Cuối cùng, tác giả phải sử dụng tới bốn máy ảo k6 để tạo đủ traffic cho server cần kiểm tra.
Những con số khiến mình bất ngờ
Kết quả cho thấy khoảng cách giữa một ứng dụng sử dụng cấu hình phổ biến và một ứng dụng được tối ưu sâu có thể lớn đến mức nào. Một số kết quả nổi bật trong thử nghiệm:
| Ngôn ngữ | Concurrent users tối đa | Điểm nổi bật |
|---|---|---|
| Ruby | 14,000 | Iodine, YJIT, tạo JSON trực tiếp trong SQLite |
| Erlang | 15,000 | Lightweight processes, một scheduler |
| Python | 22,000 | Loại bỏ các tầng xử lý không cần thiết của framework |
| Go | 22,000 | Group Commit |
| C# | 32,000 | Kestrel low-level APIs, giảm cấp phát bộ nhớ |
| Fortran | 38,000 | SQLite xử lý JSON và xác thực token |
| PHP | 40,000 | Swoole và JIT |
| C | 46,000 | io_uring, tối ưu SQLite bằng PGO |
| TypeScript trên Bun | 47,000 | Raw TCP sockets, tái sử dụng output buffer |
| Zig | 61,000 | uSockets, Group Commit |
| C++ | 64,000 | Event loop đơn, mmap, tối ưu SQLite |
| Rust | 64,000 | io_uring, batch events, Group Commit |
Chi tiết như sau:
- Ruby (14,000 concurrent users):
- Hai bản dùng Ruby on Rails tiêu chuẩn chỉ chịu được khoảng 3,000 đến 3,500 users.
- Tuy nhiên, bản Ruby nhanh nhất đã vọt lên 14,000 users (gấp 4 lần Rails) với p95 là 50ms, p99 là 154ms, 0% lỗi và CPU mới dùng 62% (nhưng lên 15,000 users thì p99 vọt lên 2.5 giây).
- Bí quyết ở đây là tác giả bản này dùng web server Iodine (viết bằng C) chạy single worker, single thread, bật trình biên dịch YJIT của Ruby. Quan trọng hơn cả là cách xử lý JSON: thay vì lấy các dòng dữ liệu từ database, khởi tạo Ruby object rồi mới chạy qua bộ JSON serializer rất tốn kém, lập trình viên đã để SQLite tự build chuỗi JSON trực tiếp và Ruby chỉ việc chuyển tiếp chuỗi đó về cho client.
- Erlang (15,000 concurrent users):
- Sử dụng web server Cowboy và tận dụng cơ chế lightweight processes đặc trưng của Erlang (mỗi kết nối một process riêng).
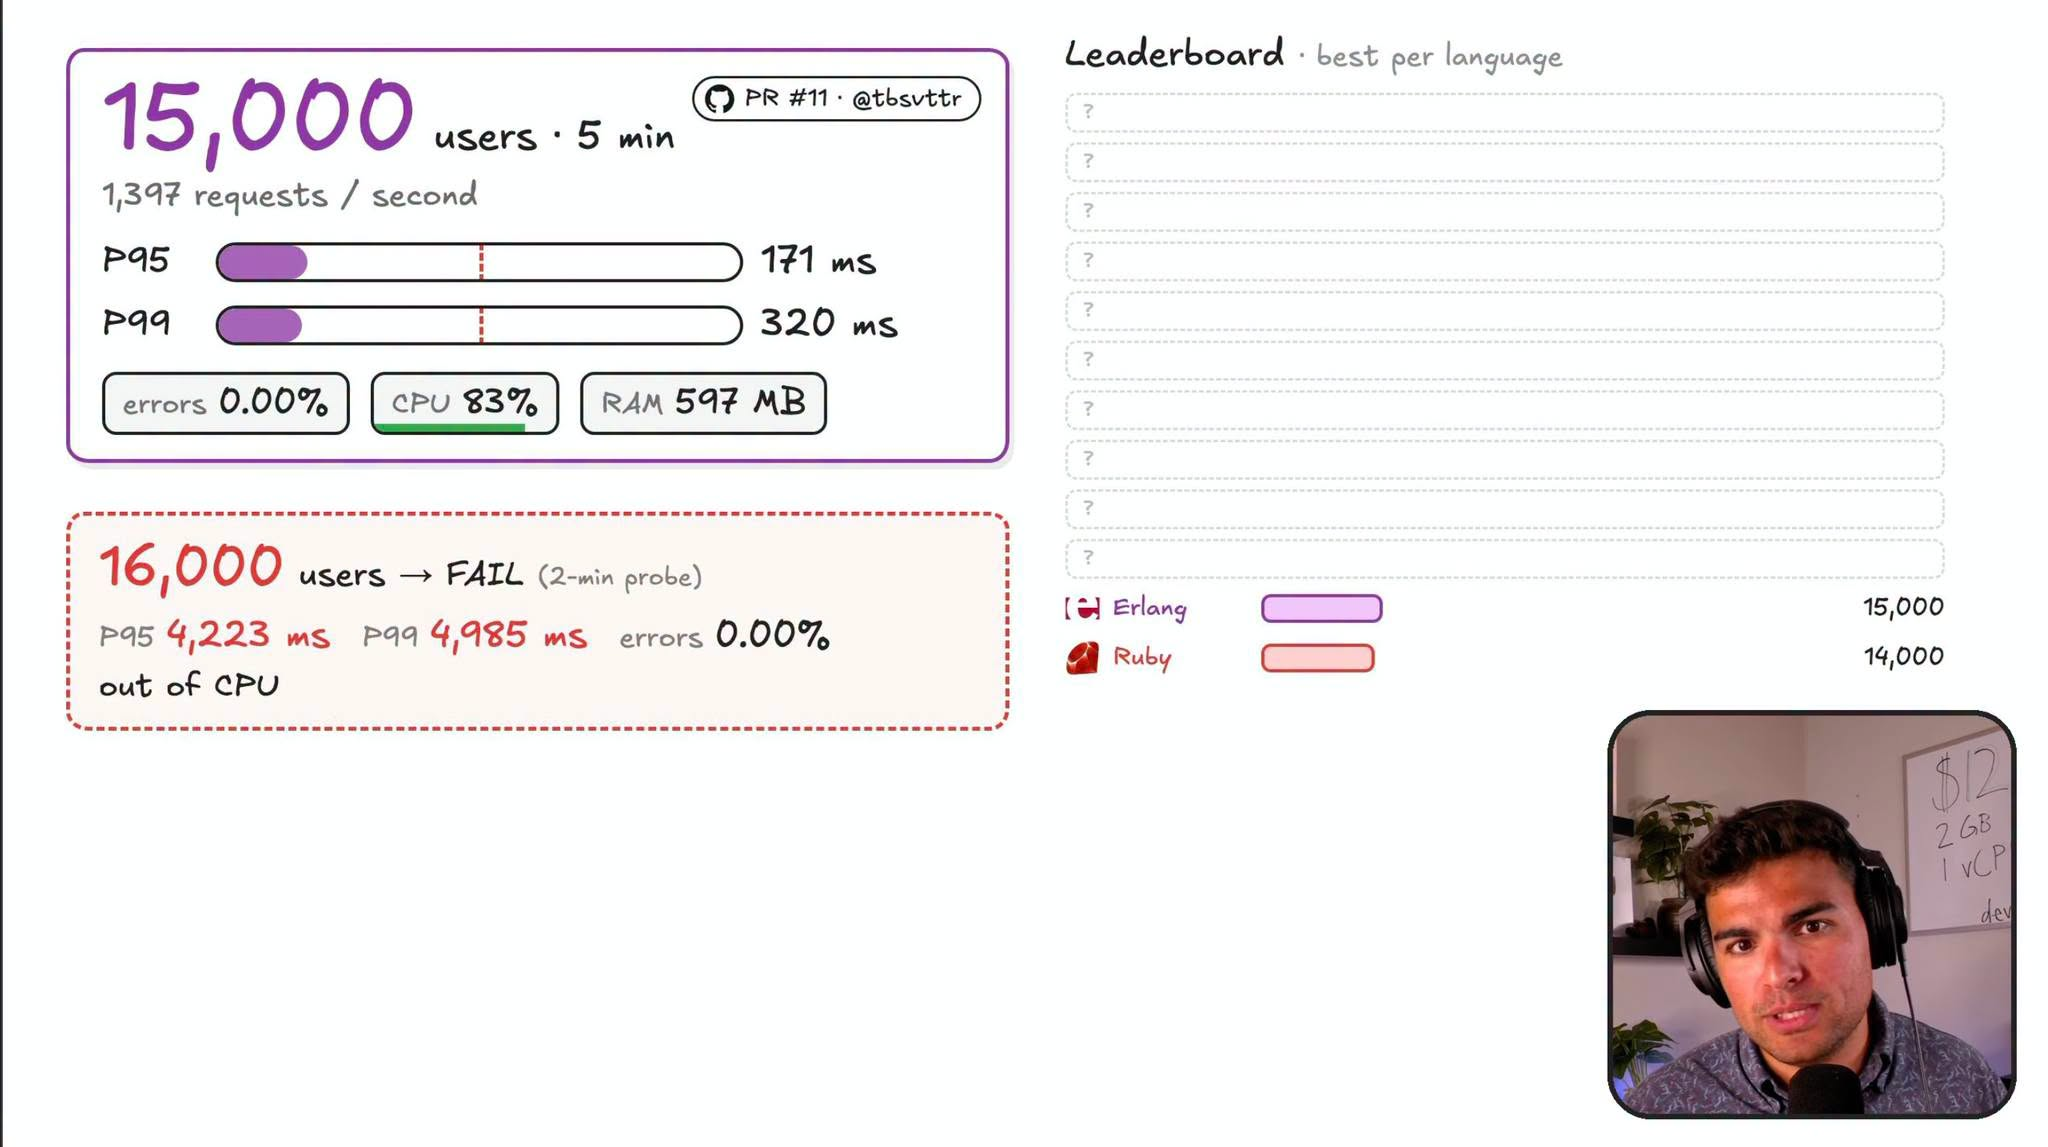
- Vì chạy trên máy chỉ có 1 vCPU, lập trình viên đã cấu hình runtime về một scheduler duy nhất và chỉ định một process độc quyền giữ kết nối SQLite, đồng thời cũng tạo JSON ngay trong SQLite.
- Ở mốc 15,000 users, p95 đạt 171ms, p99 đạt 320ms, tiêu thụ 600MB RAM và 83% CPU, trước khi bị cạn kiệt CPU ở mốc 16,000 users.
- Python (22,000 concurrent users):
- Ở video trước, FastAPI kết hợp PostgreSQL chỉ đạt 2,150 users. Lần này, một bản FastAPI tiêu chuẩn đi cùng SQLite, uvloop và orjson đạt 11,000 users.
- Sau đó, một developer khác đã nhân đôi con số này lên 22,000 users (p95 đạt 353ms, p99 đạt 653ms, CPU 91%).
- Khi chạy profiling, người này phát hiện phần lớn thời gian CPU bị tiêu tốn bên trong tầng FastAPI và Starlette chỉ để luân chuyển request qua Dependency Injection, Middleware và khởi tạo Request/Response objects. Giải pháp là gỡ bỏ toàn bộ các lớp vỏ framework đó, cho phép Uvicorn gọi thẳng vào hàm handler xử lý chính.
- Go (22,000 concurrent users):
- Chỉ có duy nhất 1 bài nộp bằng Go và đồng hạng với Python.
- Điểm sáng của bản cài đặt này là kỹ thuật Group Commit: thay vì để mỗi HTTP request tự gọi xuống SQLite, mọi thao tác được đẩy qua một goroutine duy nhất quản lý database. Goroutine này gom tối đa 256 requests mỗi lần, thực thi và commit tất cả lệnh ghi trong một transaction duy nhất rồi mới trả kết quả về cho từng client.
- Đáng tiếc là bản Go này tự giới hạn khi vượt quá 16,000 kết nối mở thì bắt đầu yêu cầu client disconnect và reconnect liên tục. Chi phí bắt tay lại ở quy mô lớn khiến tỷ lệ lỗi vượt quá 1% ở mốc 23,000 users dù CPU mới chỉ dùng hết 78% và p95 ở mốc 22,000 chỉ có 143ms.
- C# (32,000 concurrent users):
- Tăng vọt từ mức 4,400 users của video trước. Bản cài đặt này giữ lại web server Kestrel của ASP.NET Core nhưng loại bỏ hoàn toàn Middleware, Routing layer và các đối tượng HttpContext thông thường để giao tiếp trực tiếp với các low-level interfaces của Kestrel.
- Để tránh tạo gánh nặng cho bộ dọn rác (Garbage Collector) trên máy 1 core, developer đã dùng các pooled buffers để tạo JSON và xác thực token thông qua vùng nhớ cấp phát trực tiếp trên Stack (stack-allocated memory). Hệ thống đạt 32,000 users với p95 346ms, p99 731ms và vắt kiệt tới 93% CPU.
- Fortran (38,000 concurrent users):
- Một sự xuất hiện không ai ngờ tới từ ngôn ngữ ra đời từ những năm 1950 nhưng lại đánh bại cả Python, Go và C#.
- Bản này dùng thư viện C tên là libmicrohttpd để nhận kết nối HTTP rồi nối vào code Fortran. Do không dùng thư viện JSON trong Fortran, tác giả đẩy toàn bộ việc parse/build JSON và cả việc kiểm tra chữ ký login token vào thẳng bên trong câu truy vấn SQL của SQLite, kết hợp với Group Commit. Ở mốc 38,000 users, p99 là 944ms, CPU 85% và dùng 700MB RAM.
- PHP (40,000 concurrent users):
- Trong thử nghiệm ban đầu, Laravel chỉ chịu được 750 users (và PHP-FPM thuần đạt 2,700 users) do chi phí khởi tạo lại toàn bộ framework ở mỗi request.
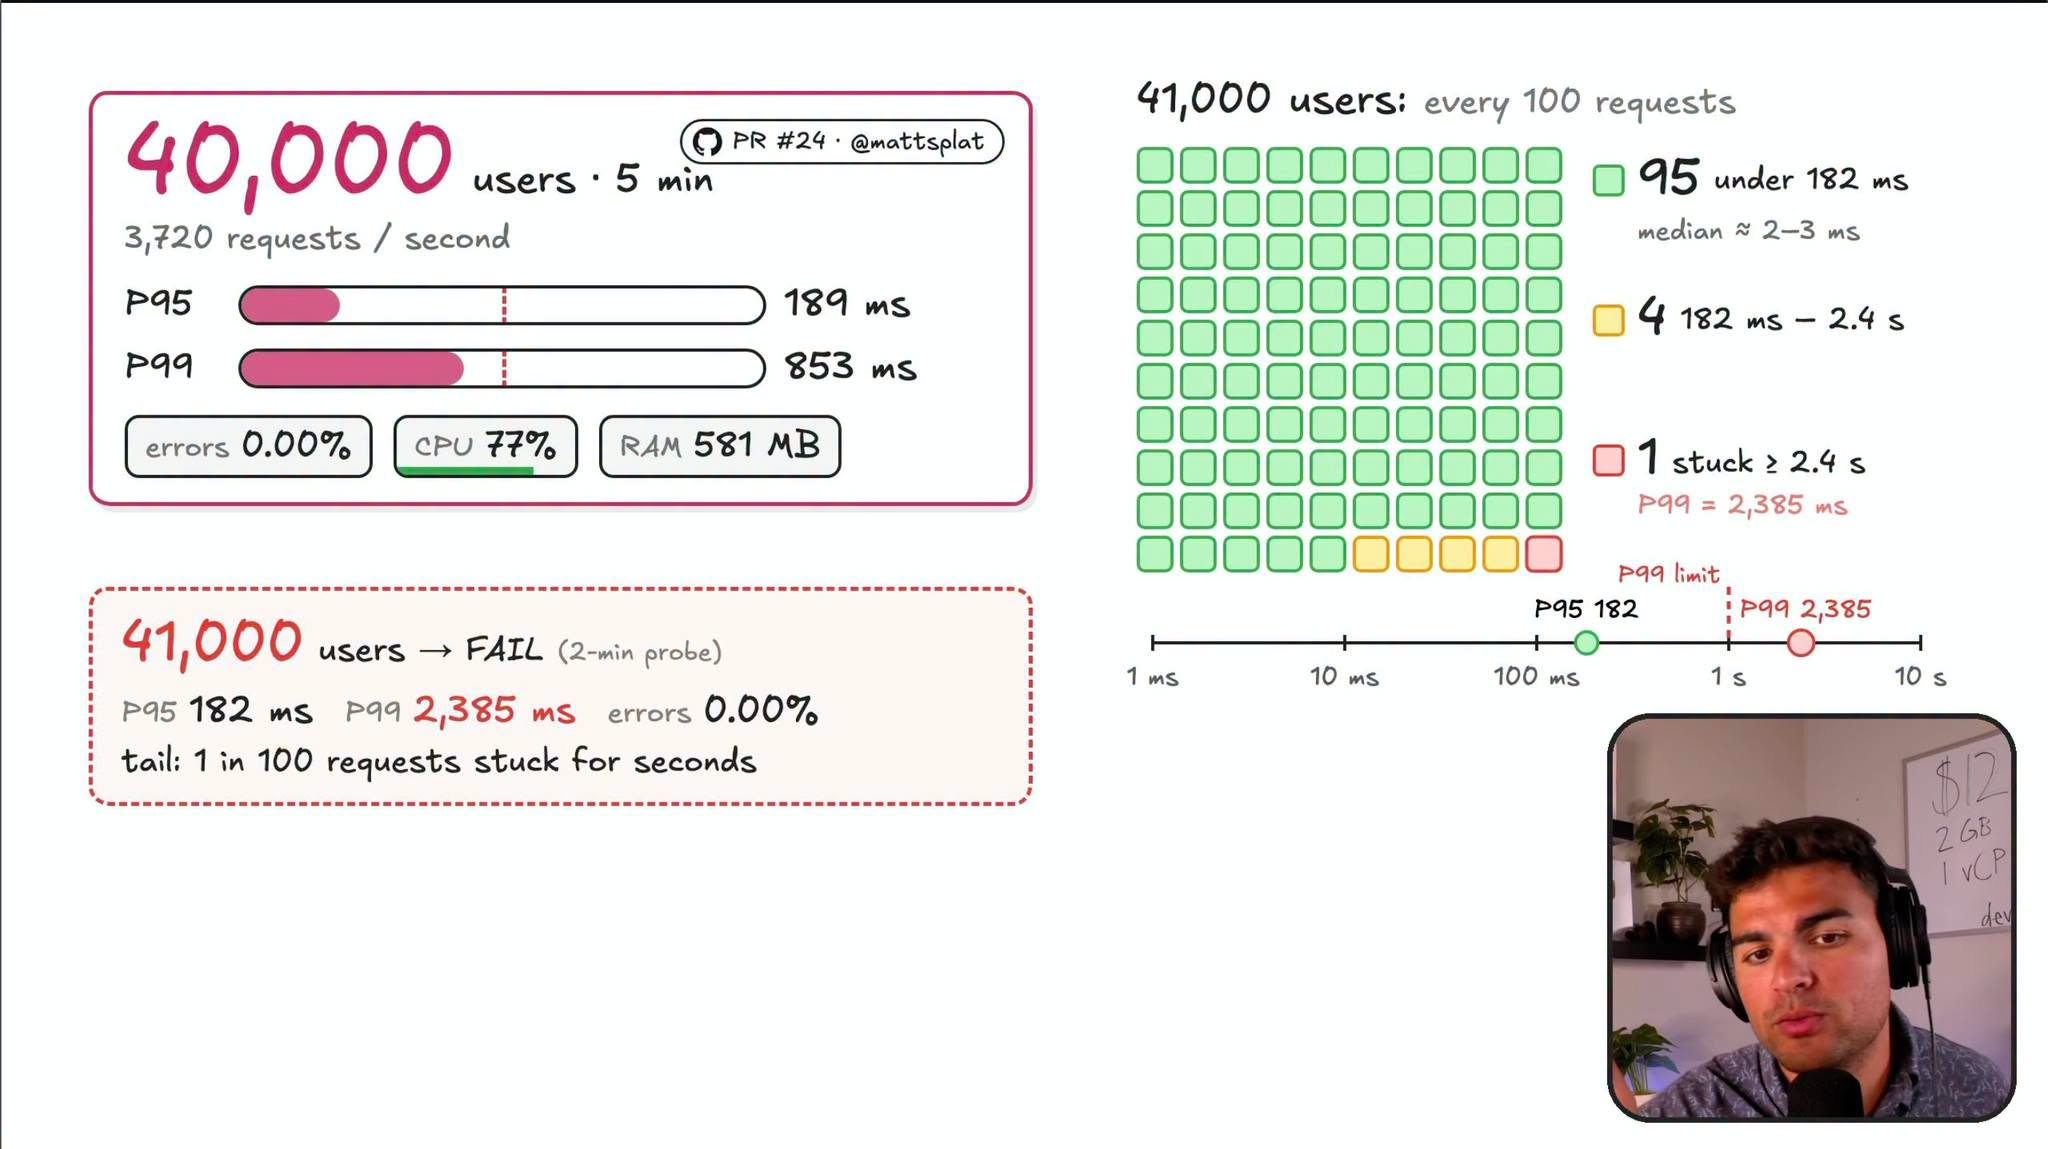
- Bản nộp lần này chỉ vỏn vẹn 250 dòng code nhưng chịu tải tới 40,000 users (gấp hơn 50 lần Laravel) với p95 chỉ 189ms và p99 là 853ms. Vũ khí bí mật là Swoole (một C extension giúp chạy PHP như một long-running server, chỉ khởi tạo ứng dụng, kết nối DB và prepare SQL queries đúng một lần duy nhất) kết hợp với việc bật trình biên dịch JIT của PHP.
- Một bản Swoole thứ hai cũng đạt tới 39,000 users nhờ patch lại Swoole để giảm RAM cho các kết nối nhàn rỗi.
- C (46,000 concurrent users):
- Sử dụng giao diện bất đồng bộ io_uring của Linux kernel để gửi và nhận các system calls theo lô (batches), giảm thiểu chi phí chuyển đổi ngữ cảnh (context switch) giữa user space và kernel space.
- Đặc biệt hơn, lập trình viên này đã áp dụng kỹ thuật Profile-Guided Optimization (PGO) ngay trong lúc biên dịch mã nguồn của SQLite: chạy thử tải thực tế để xem nhánh code nào của SQLite được gọi nhiều nhất, rồi biên dịch ra một bản binary SQLite tối ưu riêng cho đúng các câu query của bài test, đồng thời viết lại câu query lấy bài viết trên feed bằng một lần quét range scan duy nhất thay vì đếm like lặp đi lặp lại.
- Bản C này ăn cực kỳ ít tài nguyên: chỉ 39MB RAM (thấp nhất toàn giải) và 36% CPU ở mốc 46,000 users (p95 54ms, p99 178ms). Tuy nhiên ở mốc 47.000 users thì p99 bị lố 43ms (1,043ms) do thiết kế dùng 8 worker threads cùng tranh chấp 1 lock duy nhất để vào database và phải gom đủ 128 events mới xử lý một lần.
- TypeScript trên Bun (47,000 concurrent users):
- Từ mức 4,200 users ở video trước, bản cài đặt dài 350 dòng code này tăng gấp 11 lần lên 47,000 users (p95 96ms, p99 356ms, 72% CPU và 150MB RAM).
- Thay vì dùng HTTP server sẵn có của Bun, tác giả làm việc trực tiếp với raw TCP sockets và tự viết bộ parser chỉ quét đúng những byte header mà API này cần.
- Chuỗi JSON được SQLite tạo ra và trả về dưới dạng raw bytes, đẩy thẳng vào một output buffer tái sử dụng để gửi về client mà không cần ép kiểu sang chuỗi String của JavaScript, đồng thời gọi hàm C để tăng giới hạn connection backlog.
- Zig (61,000 concurrent users):
- Chỉ với khoảng 680 dòng code, sử dụng thư viện mạng uSockets (viết bằng C) và Group Commit, Zig đạt tới 61,000 users (p99 chỉ 268ms, CPU 69%).
- Lý do duy nhất khiến Zig dừng lại ở con số này là vì lập trình viên đã hardcode giới hạn 60,000 persistent connections trong code (cùng một tác giả này cũng nộp 2 bản C++ có chung giới hạn hardcode và đều dừng ở 61,000).
- Khi vượt ngưỡng này, server ép client ngắt kết nối và kết nối lại, làm phát sinh lỗi vượt mức 1%. Nếu bỏ dòng giới hạn đó đi, Zig hoàn toàn có thể chạm trần.
- Đồng quán quân: C++ và Rust (64,000 concurrent users – Chạm trần giới hạn hệ điều hành):
- Tại mốc 64.000 users, cả hai ngôn ngữ này đều đụng phải một bức tường vô hình: bảng Connection Tracking Table (conntrack) của tường lửa Linux. Trên máy ảo này, bảng conntrack được cấu hình mặc định ở mức khoảng 65,000 kết nối. Khi vượt quá 64.000 virtual users giữ kết nối mở, bảng này bị đầy và Linux kernel bắt đầu tự động drop các gói tin (packets). Vì luật chơi không cho phép can thiệp tinh chỉnh tham số của Kernel (sysctl), 64,000 trở thành điểm số tối đa trên thực tế.
- Cách tiếp cận của C++ (64,000 users):
- Chạy 1 thread, 1 event loop, không worker pool, không lock. Khi profile và thấy SQLite tốn 13% CPU chỉ để quét bộ nhớ đệm trang (page cache) nội bộ khi commit, tác giả đã thu nhỏ cache nội bộ của SQLite về gần như bằng không, và dùng kỹ thuật Memory-mapped I/O (
mmap) để việc đọc dữ liệu tận dụng trực tiếp Page Cache của hệ điều hành Linux. - Bên cạnh đó, thao tác WAL checkpoint được dời ra khỏi luồng trả kết quả request, và cấu hình WAL được đặt ở chế độ synchronous = NORMAL (chấp nhận đánh đổi một chút rủi ro mất dữ liệu nếu sập nguồn đột ngột để đổi lấy tốc độ). Ở 64,000 users, C++ có p99 latency là 910ms và dùng 68% CPU.
- Chạy 1 thread, 1 event loop, không worker pool, không lock. Khi profile và thấy SQLite tốn 13% CPU chỉ để quét bộ nhớ đệm trang (page cache) nội bộ khi commit, tác giả đã thu nhỏ cache nội bộ của SQLite về gần như bằng không, và dùng kỹ thuật Memory-mapped I/O (
- Cách tiếp cận của Rust (64,000 users – Chiến thắng chung cuộc):
- Bản Rust thứ nhất dùng framework Axum đạt 43,000 users (tốn tới 1.1GB RAM). Nhưng bản Rust thứ hai đã tự viết hệ thống dựa trên io_uring ở chế độ cho phép nhân Linux quản lý trực tiếp các tham chiếu socket (tránh cả chi phí tra cứu bảng file descriptor thông thường), kết hợp gom batch events trong event loop và Group Commit.
- Kết quả ở mức 64,000 users thật sự đáng kinh ngạc: p99 latency chỉ có 224ms (thấp hơn rất nhiều so với 910ms của C++), RAM tốn dưới 100MB, và CPU mới chỉ chạy hết 52%. Nhờ dư địa phần cứng còn trống quá lớn, Rust được trao ngôi vị quán quân tuyệt đối.
Điều đáng chú ý là những ngôn ngữ thường được xem là lựa chọn mặc định cho backend không nhất thiết đứng đầu. Ngược lại, Fortran, C và Zig đều có màn thể hiện rất ấn tượng. Tuy nhiên, mình nghĩ không nên nhìn bảng kết quả này như một bảng xếp hạng tuyệt đối về tốc độ của các ngôn ngữ. Đây là kết quả của những bản triển khai cụ thể, với kiến trúc, thư viện và mức độ tối ưu rất khác nhau.
Một số bài học kỹ thuât trong bài toán tối ưu
Điều mình quan tâm hơn trong thử nghiệm này là các tác giả đã làm gì để đạt được những con số đó.
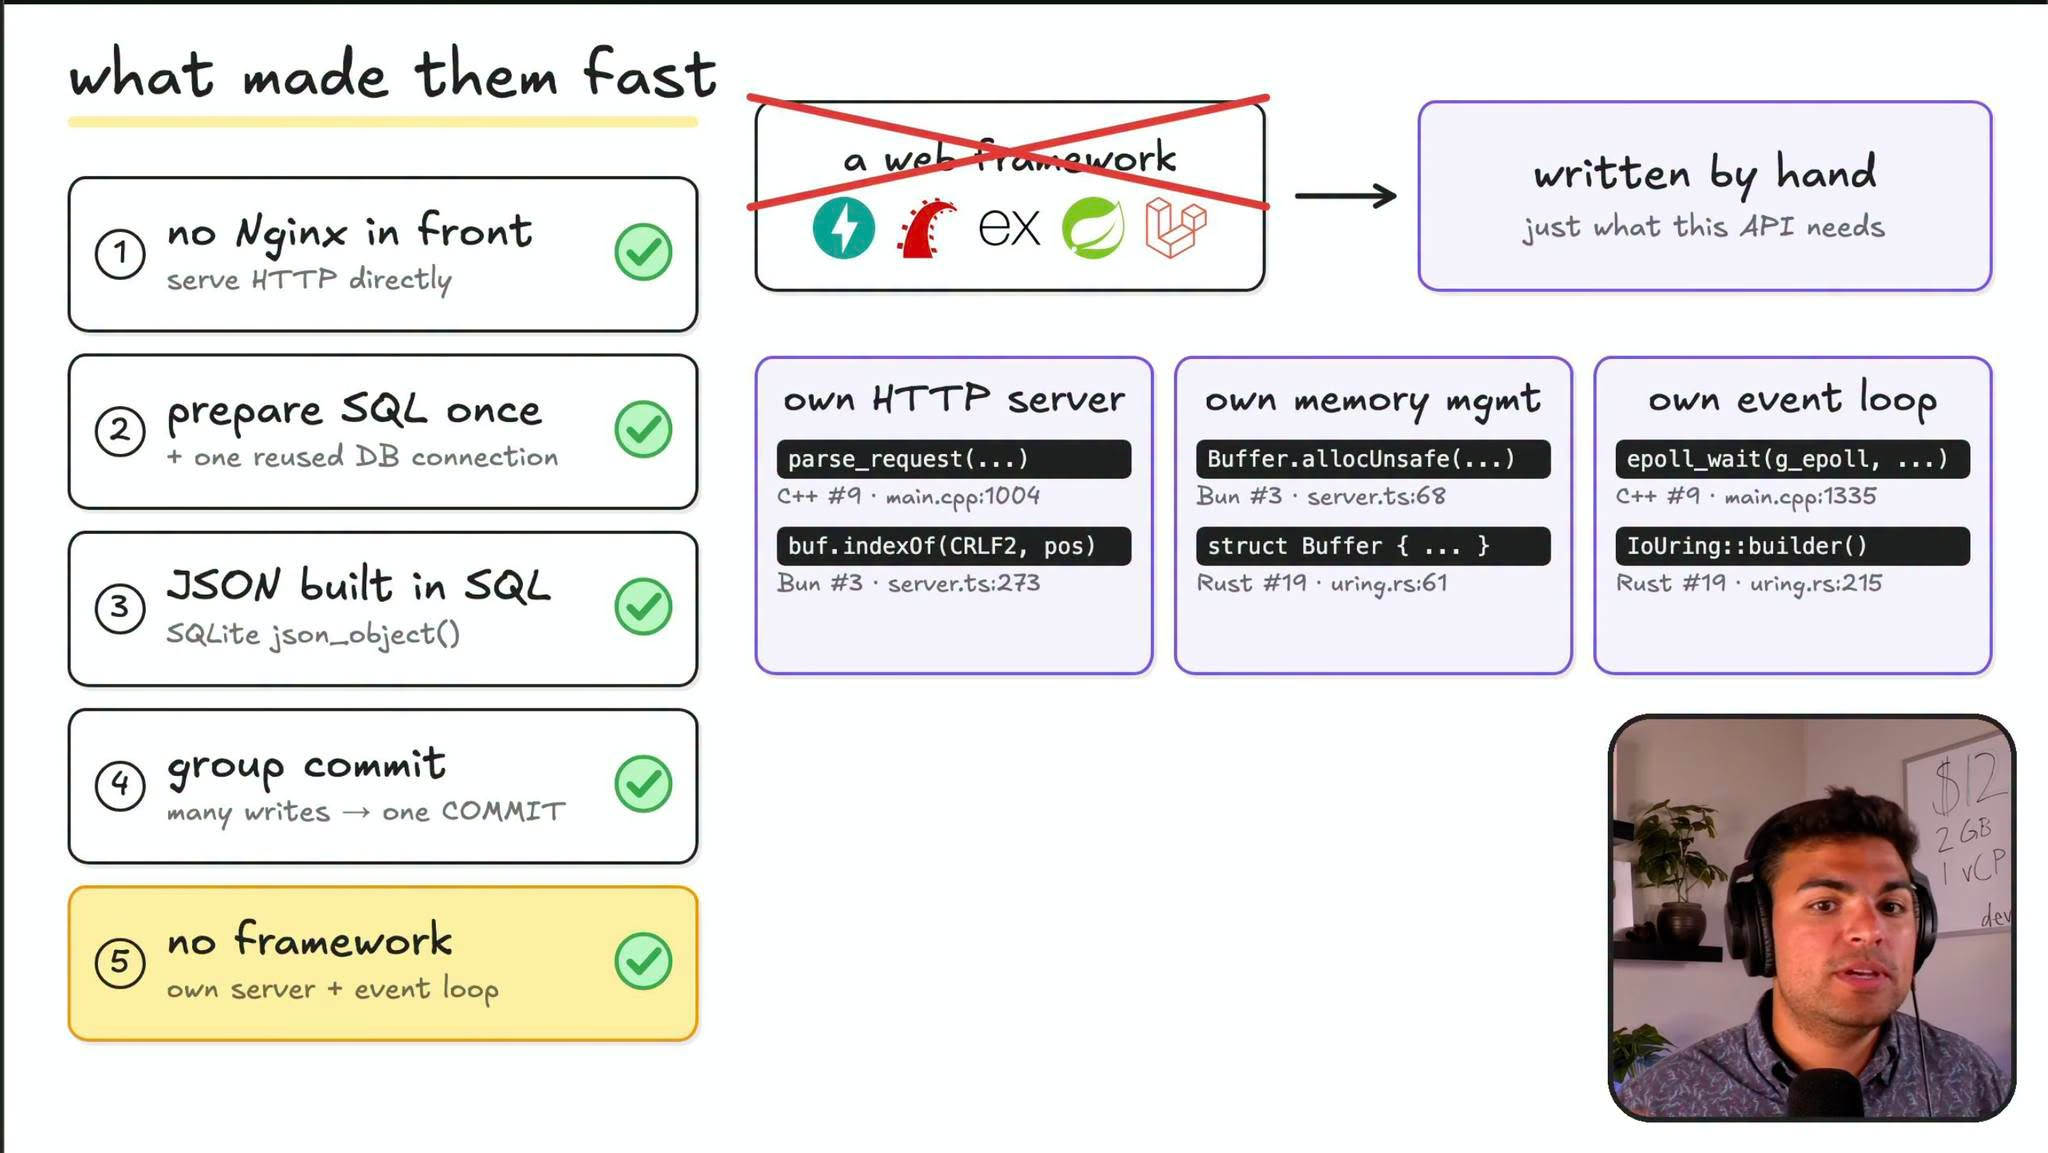
Bài học đầu tiên: Framework có thể trở thành chi phí đáng kể
Một trong những ví dụ dễ hình dung nhất là Python:
- Bản FastAPI tiêu chuẩn sử dụng SQLite, uvloop và orjson đạt khoảng 11,000 concurrent users. Sau đó, một lập trình viên khác đã nâng kết quả lên 22,000 users.
- Khi profiling, người này nhận ra một phần đáng kể CPU bị tiêu tốn trong chính các tầng xử lý của FastAPI và Starlette: Dependency Injection, Middleware, khởi tạo Request/Response và các bước điều phối request.
- Giải pháp là loại bỏ những tầng không cần thiết, để Uvicorn gọi trực tiếp vào hàm xử lý chính => Kết quả tăng gấp đôi.
Một câu chuyện tương tự xuất hiện ở PHP. Trong khi Laravel chỉ đạt khoảng 750 users và PHP-FPM thuần đạt khoảng 2,700 users ở thử nghiệm ban đầu, một bản triển khai dùng Swoole đạt tới 40,000 users. Swoole cho phép PHP chạy dưới dạng một server tồn tại lâu dài, thay vì phải khởi tạo lại toàn bộ ứng dụng cho mỗi request như mô hình truyền thống. Nhờ đó, kết nối database và các câu lệnh SQL đã chuẩn bị có thể được tái sử dụng.
Từ hai ví dụ này, mình rút ra một điều: Framework không chậm chỉ vì nó là framework. Nó chậm hơn trong một số tình huống vì cung cấp nhiều chức năng mà ứng dụng cụ thể không thực sự cần đến. Trong phần lớn dự án, những lớp trừu tượng đó giúp code dễ bảo trì, dễ mở rộng và an toàn hơn. Nhưng khi một ứng dụng đã chạm giới hạn hiệu năng, việc đo đạc và xác định chính xác chi phí của từng tầng có thể đem lại lợi ích lớn hơn nhiều so với việc thay đổi ngôn ngữ lập trình.
Bài học thứ hai: Database có thể làm nhiều việc hơn chúng ta nghĩ
Mình đặc biệt thích kỹ thuật xuất hiện trong nhiều bản triển khai: Để SQLite tạo JSON trực tiếp.
Thông thường, luồng xử lý dữ liệu của một ứng dụng backend sẽ diễn ra như sau:
- Truy vấn database.
- Lấy kết quả về ứng dụng.
- Chuyển từng dòng dữ liệu thành object.
- Dùng thư viện serialize object thành JSON.
- Gửi JSON về client.
Mỗi bước đều có chi phí. Ứng dụng phải tạo object, quản lý bộ nhớ, sao chép dữ liệu và chạy thêm logic chuyển đổi. Nếu kết quả truy vấn có thể được tạo thành JSON ngay trong SQLite, ứng dụng không nhất thiết phải thực hiện toàn bộ chuỗi xử lý trên.
Một số bản triển khai đã áp dụng cách này, thậm chí còn để SQLite xử lý một phần logic xác thực token. Điều đó không có nghĩa là mọi logic đều nên chuyển xuống database. Tuy nhiên, nếu database đã có thể trả về đúng định dạng mà ứng dụng cần, việc tạo thêm một lớp chuyển đổi dữ liệu đôi khi chỉ làm tăng chi phí.
Đây cũng là lời nhắc rằng tối ưu hiệu năng không nhất thiết đồng nghĩa với việc viết code phức tạp hơn. Đôi khi, giải pháp tốt hơn là giảm số lần chuyển đổi dữ liệu giữa các tầng.
Group Commit: Một kỹ thuật đáng quan tâm
Nếu phải chọn một kỹ thuật có tính ứng dụng thực tế cao trong số những gì mình đọc được, mình sẽ chọn Group Commit. Thông thường, mỗi request ghi dữ liệu sẽ thực hiện một transaction riêng. Với SQLite, nếu nhiều request liên tục ghi dữ liệu, chi phí transaction và đồng bộ ghi có thể trở thành nút thắt.
Group Commit thay đổi cách tiếp cận. Thay vì để từng request tự thực hiện transaction, hệ thống gom nhiều thao tác ghi lại, đưa chúng vào một transaction chung, commit một lần rồi trả kết quả cho từng request.
Ví dụ, bản Go trong thử nghiệm gom tối đa 256 request mỗi lần. Một số bản triển khai khác cũng sử dụng cơ chế tương tự để giảm chi phí ghi database. Hình dung đơn giản, thay vì thực hiện 256 lần ghi độc lập, hệ thống có thể gom các thao tác phù hợp vào một transaction để chia sẻ chi phí xử lý.
Tất nhiên, Group Commit không phải phép màu. Hệ thống phải quản lý hàng đợi, thời gian chờ, kết quả của từng request và trường hợp transaction thất bại. Nếu một batch gặp lỗi, nhiều request có thể bị ảnh hưởng cùng lúc. Nếu việc gom batch kéo dài quá lâu, latency cũng tăng lên.
Nhưng với workload có nhiều thao tác ghi và yêu cầu commit trước khi trả response, đây là một kỹ thuật đáng để thử nghiệm.
Từ C đến Rust: Khi tối ưu đi sâu xuống hệ điều hành
C, C++ và Rust là nhóm khiến mình ấn tượng nhất ở phần cuối của cuộc thi.
Bản C đạt 46,000 users nhờ sử dụng io_uring, một giao diện I/O bất đồng bộ của Linux. Thay vì xử lý từng thao tác hệ thống theo cách thông thường, ứng dụng có thể gửi và nhận các yêu cầu I/O theo lô, giảm một phần chi phí chuyển đổi giữa user space và kernel space. Tác giả còn sử dụng Profile-Guided Optimization (PGO) để tối ưu SQLite dựa trên hành vi thực tế của workload benchmark. Cách tiếp cận này giúp trình biên dịch tối ưu những nhánh code được sử dụng thường xuyên, thay vì chỉ dựa vào các giả định chung.
Bản C++ đạt 64,000 users với một thread và một event loop. Một số kỹ thuật đáng chú ý gồm:
- Sử dụng memory-mapped I/O (mmap) để tận dụng page cache của hệ điều hành.
- Giảm cache nội bộ của SQLite sau khi profiling cho thấy chi phí đáng kể tại đây.
- Dời WAL checkpoint ra khỏi luồng trả kết quả request.
- Điều chỉnh chế độ đồng bộ ghi của SQLite để ưu tiên hiệu năng.
Ở mốc 64.000 users, bản C++ có p99 latency khoảng 910 ms và sử dụng 68% CPU.
Nhưng người chiến thắng chung cuộc là Rust. Bản Rust dùng Axum chỉ đạt khoảng 43,000 users. Bản tối ưu sâu hơn sử dụng io_uring, tự quản lý event loop, gom batch events và Group Commit. Kết quả ở mốc 64,000 concurrent users:
- p99 latency chỉ 224 ms.
- RAM dưới 100 MB.
- CPU sử dụng khoảng 52%.
Như vậy, cả C++ và Rust đều chạm ngưỡng 64,000 users, nhưng Rust có độ trễ thấp hơn đáng kể và vẫn còn nhiều dư địa tài nguyên hơn.
Một điểm quan trọng: 64,000 không phải giới hạn lý thuyết của Rust hay C++. Theo kết quả được mô tả, hệ thống đã chạm giới hạn Connection Tracking Table của Linux kernel trên máy ảo benchmark. Đây là giới hạn môi trường thử nghiệm, không phải giới hạn cố hữu của ngôn ngữ.
Nhưng liệu có nên viết backend như vậy trong production?
Đây mới là phần mình cho rằng đáng suy nghĩ nhất. Khi nhìn thấy một ứng dụng xử lý 64,000 concurrent users trên server 12 USD/tháng, chúng ta rất dễ đi đến kết luận rằng các framework phổ biến đang quá nặng nề và nên bị loại bỏ. Mình không nghĩ đơn giản như vậy.
Các bản triển khai nhanh nhất thường phải đánh đổi rất nhiều thứ, đặc biệt là sử dụng các kỹ thuật hết sức CỰC ĐOAN khó có thể sử dụng trong môi trường Production của các doanh nghiệp lớn:
- Một số tác giả tự viết parser HTTP, thao tác trực tiếp với raw TCP socket, tự quản lý bộ nhớ và loại bỏ phần lớn các tầng trừu tượng thông thường. Bản Rust nhanh nhất sử dụng nhiều khối unsafe và phụ thuộc vào các tính năng tương đối thấp cấp của Linux.
- Bản TypeScript trên Bun chỉ xử lý đúng những dạng request và header cần thiết cho năm endpoint của bài thi. Cách triển khai như vậy không thể mặc nhiên được xem là một HTTP server tổng quát, an toàn và dễ mở rộng.
- Ngay cả Group Commit cũng có thể tạo ra vấn đề nếu một transaction thất bại hoặc một câu query bị chậm, khiến các request khác trong cùng hàng đợi phải chờ.
- Ngoài ra, việc điều chỉnh cấu hình đồng bộ ghi của SQLite cũng cần được cân nhắc cẩn thận. Chẳng hạn, synchronous = NORMAL có thể cải thiện hiệu năng nhưng đi kèm sự đánh đổi về độ bền dữ liệu trong một số tình huống sự cố.
Một benchmark được kiểm soát chặt chẽ và một hệ thống production có yêu cầu thực tế là hai bài toán khác nhau. Production còn phải xử lý TLS, giới hạn request, bảo mật, quan sát hệ thống, triển khai phiên bản mới, xử lý lỗi, mở rộng chức năng và duy trì code trong nhiều năm.
Vì thế, mình không cho rằng kết quả này chứng minh chúng ta nên bỏ Nginx, FastAPI, Spring Boot hay các framework khác. Nó chỉ cho thấy rằng khi workload đủ cụ thể và giới hạn đủ chặt, việc loại bỏ các chi phí không cần thiết có thể tạo ra khác biệt rất lớn.
Năm điều mình rút ra từ thử nghiệm này
Sau khi xem toàn bộ kết quả, mình nghĩ có năm bài học đáng nhớ.
- Thứ nhất, hãy profiling trước khi tối ưu.
Đừng mặc định database là nút thắt, cũng đừng mặc định ngôn ngữ lập trình là nguyên nhân. CPU có thể đang tiêu tốn thời gian vào middleware, serialize JSON, cấp phát bộ nhớ hoặc đồng bộ giữa các luồng. Chỉ khi biết chính xác chi phí nằm ở đâu, chúng ta mới có thể chọn đúng giải pháp. - Thứ hai, giảm công việc thừa thường hiệu quả hơn tăng tài nguyên.
Loại bỏ một bước chuyển đổi dữ liệu, tái sử dụng prepared statements hay tránh tạo object không cần thiết có thể tạo ra cải thiện đáng kể mà không cần nâng cấp server. - Thứ ba, cần hiểu cách database vận hành.
SQLite không đơn giản chỉ là một database nhỏ dành cho ứng dụng desktop. Trong workload phù hợp, việc chạy database ngay trong process có thể giảm chi phí giao tiếp và giúp kiến trúc gọn hơn. Tuy nhiên, lựa chọn này vẫn phải phù hợp với mô hình ghi dữ liệu, mức độ đồng thời và yêu cầu vận hành của hệ thống. - Thứ tư, kiến trúc và cách triển khai quan trọng không kém ngôn ngữ.
Một ứng dụng viết bằng Python nhưng được tối ưu đúng chỗ hoàn toàn có thể vượt xa một ứng dụng dùng ngôn ngữ nhanh hơn nhưng kiến trúc chưa phù hợp. Bảng benchmark này là một ví dụ khá rõ. - Thứ năm, tối ưu phải đi cùng mục tiêu thực tế.
Nếu ứng dụng chỉ cần phục vụ vài nghìn người dùng với chi phí vận hành hợp lý, việc dành nhiều tuần viết lại HTTP server có thể không đáng giá. Nhưng nếu hệ thống đang thực sự bị giới hạn bởi CPU hoặc độ trễ, những kỹ thuật cấp thấp này sẽ trở nên hữu ích.
Lời kết
Điều mình thích nhất ở thử nghiệm này không phải là Rust đứng đầu, cũng không phải con số 64,000 concurrent users. Đó là cách những lập trình viên đi từ một ứng dụng khá thông thường đến việc hiểu sâu từng phần của hệ thống: request đi qua những tầng nào, dữ liệu được chuyển đổi ra sao, SQLite tiêu tốn CPU ở đâu, bộ nhớ được cấp phát như thế nào và Linux xử lý I/O ra sao.
Khi hiểu được những điều đó, tối ưu hiệu năng không còn là việc đoán xem ngôn ngữ nào nhanh hơn hay mua một chiếc server mạnh hơn. Nó trở thành quá trình xác định chi phí thực sự và loại bỏ những phần không cần thiết, đồng thời giữ nguyên các yêu cầu quan trọng về tính đúng đắn và độ tin cậy.
Và có lẽ đây cũng là điều mình muốn nhớ nhất sau khi xem video: Framework giúp chúng ta xây dựng phần mềm nhanh hơn, nhưng hiểu sâu hệ thống mới giúp chúng ta biết khi nào framework đang trở thành chi phí và cần tối ưu ở đâu.
Mình cũng khá tò mò: Nếu đưa Java với Spring Boot, Virtual Threads hoặc Netty vào cùng bài benchmark này, kết quả sẽ như thế nào? Liệu một kiến trúc được tối ưu tốt có thể cạnh tranh với những bản Rust và C++ viết sát hệ điều hành hay không? Đây chắc chắn sẽ là một thử nghiệm đáng xem.
Nếu bạn có góc nhìn khác hoặc từng tối ưu một hệ thống backend đến giới hạn tương tự, hãy chia sẻ nhé. Mình rất muốn biết trong thực tế, kỹ thuật nào mang lại hiệu quả lớn nhất mà vẫn giữ được code dễ bảo trì.
Lưu ý: Các số liệu trong bài được giữ theo nội dung benchmark được mô tả trong nguồn ban đầu; đây là kết quả của những bản triển khai cụ thể trong một môi trường thử nghiệm nhất định, không phải bảng xếp hạng tổng quát về hiệu năng của các ngôn ngữ lập trình.

 Mình là lập trình viên, mặc dù cũng đã khá lớn tuổi nhưng vẫn thích Lập trình. Gần đây mình tập trung tìm hiểu nhiều hơn về Lĩnh vực Blockchain. Với kiến thức tìm hiểu được, mình muốn viết ra để lưu lại cũng như để chia sẻ cho những người quan tâm. Mong mọi người góp ý và có thể cùng mình chia sẻ nhiều kiến thức hơn cho cộng đồng.






Trả lời