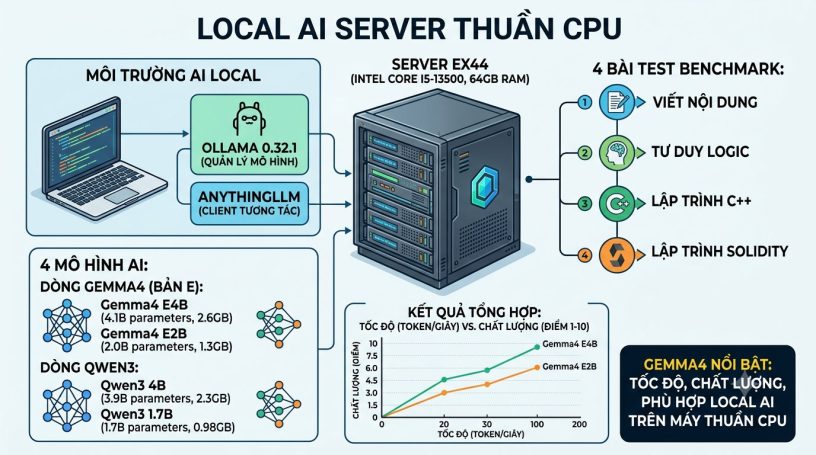
Trong bài viết này, tôi sẽ tự xây dựng một hệ thống Local AI chạy hoàn toàn trên server CPU, không phụ thuộc vào GPU hay các dịch vụ AI bên ngoài. Quá trình sẽ bao gồm cài đặt môi trường, triển khai mô hình, tối ưu hiệu năng và theo dõi mức sử dụng tài nguyên. Tôi cũng sẽ thử nghiệm và benchmark một số mô hình AI phổ biến như Qwen, từ đó đánh giá tốc độ, chất lượng phản hồi, mức tiêu thụ RAM và khả năng đáp ứng các tác vụ thực tế.
Mục lục
Môi trường thử nghiệm
Hiện tại môi trường thử nghiệm mà tôi thực hiện như sau:
- Server: Máy chủ chuyên dụng EX44 được trang bị:
- Bộ vi xử lý Intel® Core™ i5-13500 thế hệ thứ 13 với công nghệ Hyper-Threading, sở hữu tới 6 nhân hiệu năng cao và 8 nhân tiết kiệm điện
- 64 GB RAM DDR4
- Hai ổ cứng SSD NVMe Gen4 tốc độ cao dung lượng 512 GB
- Trạng thái sử dụng bình thường: 3% CPU + 20 GB RAM
- Phần mềm sử dụng cho AI:
- Ollama 0.32.1 cài đặt trên server EX44 ở trên sử dụng hệ điều hành Ubuntu 22.04.4 LTS => Đóng vai trò quản lý và chạy các mô hình AI
- AnythingLLM chạy trên máy cá nhân sử dụng hệ điều hanh Ubuntu 22.04.5 LTS => Đóng vai trò làm Client để tương tác với các mô hình AI
Hướng dẫn cài đặt
Đầu tiên, bạn cần cài đặt ollama trên server và tải các mô hình cần thực hiện test. Lệnh cài đặt Ollama trên server như sau:
# Cài đặt
curl -fsSL https://ollama.com/install.sh | sh

# Sửa để chạy ở HOST 0.0.0.0
# Mở tệp /etc/systemd/system/ollama.service thêm dòng sau:
# Environment="OLLAMA_HOST=0.0.0.0:11434"
# Sửa xong đánh lệnh sau để chạy lại
systemctl daemon-reload
systemctl restart ollama

# Xem các lệnh hỗ trợ trên ollama
ollama --help

# Chúng ta sẽ tải 4 model sau để test
ollama pull gemma4:e2b
ollama pull gemma4:e4b
ollama pull qwen3:4b
ollama pull qwen3:1.7b
Tiếp theo, chúng ta cần cài AnythingLLM trên máy cá nhân để kết nối tới Ollama trên Server. Trên máy cá nhân chúng ta đến trang AnythingLLM Download tải về và cài đặt, sau đó bật AnythingLLM vào phần “Application Settings“, tới mục “AI Providers -> LLM“, chọn Ollama và nhập URL trỏ tới Ollama cài đặt trên server. Nhớ mở kết nối để máy bạn có thể truy cập tới server ở cổng 11434.
Tôi thấy gemma4 và qwen3 được cộng đồng sử dụng khá nhiều nên tôi quyết định test thử 2 mô hình này. Tôi đã thử trước với mô hình 8 tỷ tham số (8b) mặc dù vẫn load được nhưng khi chạy khá chậm nên tôi không sử dụng. Tôi cũng đã thử qwen3.5 nhưng thấy output không được như qwen3. Cuối cùng tôi chốt sử dụng 2 mô hình sau để kiểm tra và mỗi mô hình sử dụng 2 phiên bản:
- Gemma4: Dòng mô hình mã nguồn mở do Google phát triển.
- gemma4:e2b => Mô hình dạng MoE có hiệu năng tương đương với 2 tỷ tham số hoạt động, dung lượng 7.2G
- gemma4:e4b => Mô hình dạng MoE có hiệu năng tương đương với 4 tỷ tham số hoạt động, dung lượng 9.6G
- Qwen3: Dòng mô hình ngôn ngữ lớn (LLM) do tập đoàn Alibaba phát triển
- qwen3:1.7b => Mô hình dạng MoE kết hợp nén với 1.7 tỷ tham số, dung lượng 1.4G
- qwen3:4b => Mô hình dạng MoE kết hợp nén với 4 tỷ tham số, dung lượng 2.6G
Benchmark 04 mô hình AI qua 4 bài test
Tôi đã test thử các mô hình ở 4 bài test ở mức độ trung bình tương ứng với 4 hạng mục khác nhau:
- Viết bài đơn giản
- Tư duy logic
- Lập trình C++
- Lập trình Solidity
Bài Test 01: Viết bài đơn giản
Yêu cầu bài test này đơn giản như sau:
Viết bài giải thích đơn giản về Bitcoin cho người mới trong vòng 200 từ.Bài này có thể có một số ý quan trọng:
- Là tiền kỹ thuật số, phi tập trung
- Giao dịch không cần trung gian, không cần ngân hàng trung ương hay chính phủ
- Sử dụng công nghệ blockchain và công nghệ mã hóa để lưu giao dịch an toàn và minh bạch
- Bảo mật mạng lưới thông qua cơ chế mining, giải bài toán phức tạp để nhận thưởng
- Tổng cung tối đa 21 triệu
- Tài sản có tính biến động mạnh
Và đây là kết quả:
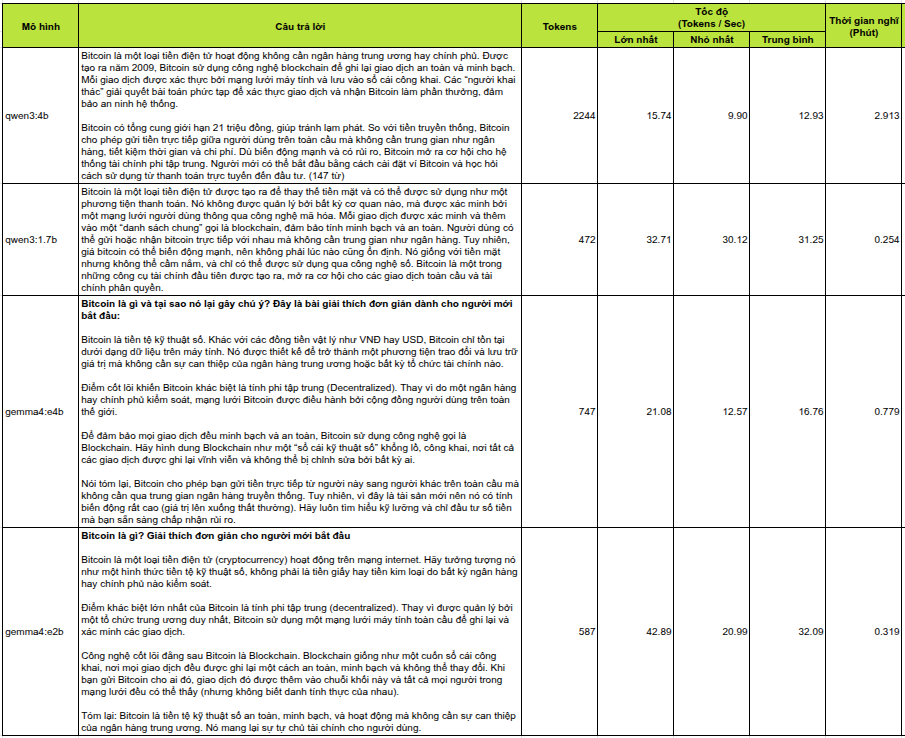
Trên quan điểm cá nhân thì tôi thích bài của Gemma4 hơn, và tốc độ của Gemma4 cũng nhanh hơn.
Bài Test 02: Tư duy logic
Đề bài như sau:
Có 5 người: A, B, C, D và E. Mỗi người thích một loại trái cây khác nhau: Táo, Cam, Chuối, Xoài và Nho.
Biết rằng:
1. A không thích Táo hoặc Cam.
2. B thích Chuối hoặc Nho.
3. C không thích Chuối.
4. D không thích Xoài.
5. E không thích Táo.
6. Người thích Nho không phải là A.
7. B không thích Nho.
8. Mỗi người chỉ thích đúng 1 loại quả
9. Hai người không thích cùng 1 loại quả
Hỏi rằng mỗi người thích loại trái cây nào? Hãy liệt kê tất cả các kết quả có thể xảy ra trong một bảng.
Bài này có 4 kết quả như sau:
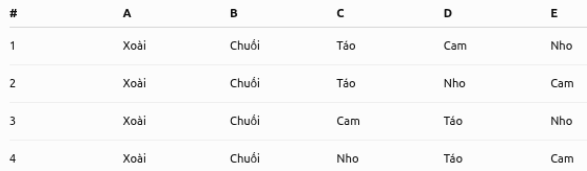
Đây là kết quả từ 4 mô hình trả về, vì kết quả dài nên mình xuất ra dạng pdf:
- qwen3-4b-tuduy-logic.pdf => Kết quả đúng như sơ sài
- qwen3-1.7b-tuduy-logic.pdf => Kết quả sai
- gemma4-e4b-tuduy-logic.pdf => Kết quả đúng
- gemma4-e2b-tuduy-logic.pdf => Kết quả đúng
Còn ảnh dưới là kết quả tổng hợp:
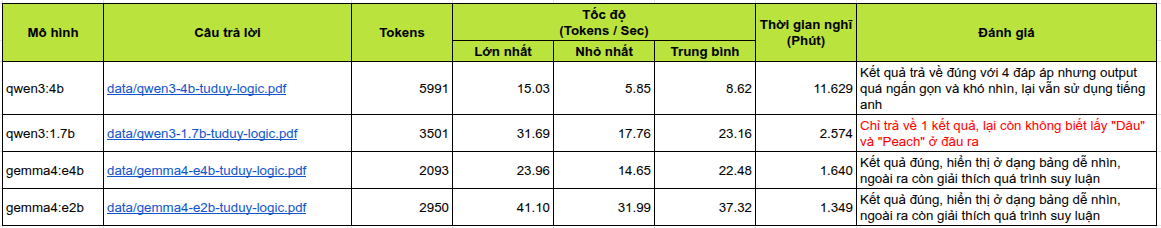
Trong bài test này, Gemma4 lại cho lợi thế vượt trội về cả kết quả lẫn tốc độ.
Bài Test 03: Lập trình C++
Đề bài như sau:
Hãy viết code bằng C++ để thực hiện bài toán dưới:
Một người cần rút một số tiền T từ ngân hàng và muốn tổng số tờ ít nhất. Cho biết có các loại tiền mệnh giá 100, 20, 5 và 1. Nhập từ bàn phím số tiền T và in ra số tờ mỗi loại mệnh giá và tổng số tờ nhận được.
Đây là kết quả từ 4 mô hình trả về:
- qwen3-4b-code-c.pdf => Code phải sửa chút mới chạy, format code khó nhìn, không có comment. Khi chạy thì đoạn nhập không có thông báo.
- qwen3-1.7b-code-c.pdf => Code chạy ngon, format chuẩn hơn nhưng code không có comment
- gemma4-e4b-code-c.pdf => Code chạy okie, format đẹp hơn, code có comment, lại có nói rõ sử dụng thuật toán nào. Nhưng trong code, có đoạn hiển thị số tiền T cần rút bị sai.
- gemma4-e2b-code-c.pdf => Code chạy ngon, format dễ nhìn, có comment đầy đủ, nhưng không nói rõ thuật toán sử dụng.
Còn ảnh dưới là kết quả tổng hợp:
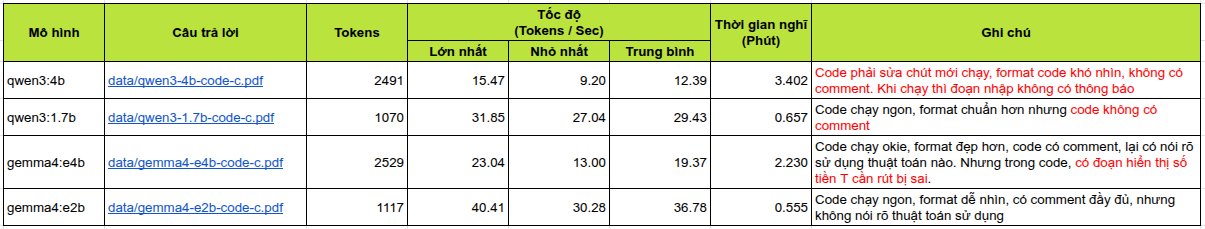
Trong bài test này, Gemma4 vẫn cho lợi thế vượt trội về cả kết quả lẫn tốc độ. Điều làm mình ngạc nhiên là mô hình ít tham số hơn lại cho kết quả tốt hơn.
Bài Test 04: Lập trình Solidity
Đề bài như sau:
Xây dựng Smart Contract thực hiện Quản lý Quỹ Nhóm sử dụng Solidity 0.8 trở lên với yêu cầu chức năng như sau:
1. Khởi tạo
 • Người triển khai contract (deployer) mặc định là owner của quỹ.
 • Cho phép đặt một hạn mức tối đa cho mỗi lần rút tiền (đơn vị: Wei).
2. Nạp tiền
 • Bất kỳ ai cũng có thể gửi Ether vào contract này.
 • Cập nhật số dư đóng góp của từng địa chỉ ví.
 • Phát ra sự kiện xác định thông tin nạp tiền.
3. Rút tiền
 • Chỉ owner mới có quyền gọi hàm rút tiền.
 • Số tiền rút không được vượt quá số dư hiện tại của quỹ và không vượt quá hạn mức tối đa mỗi lần rút.
 • Phát ra sự kiện xác định thông tin rút tiền
4. Hàm kiểm tra số dư
 • Trả về tổng số dư Ether hiện có trong hợp đồng thông minh
Mình không đưa template làm đầu vào nhưng mong muốn các mô hình cho ra code gần giống template dưới:
// SPDX-License-Identifier: MIT
pragma solidity ^0.8.0;

contract GroupWallet {
    address public owner;
    uint256 public maxWithdrawLimit;

    mapping(address => uint256) public balances;

    event Deposit(address indexed sender, uint256 amount);
    event Withdraw(address indexed receiver, uint256 amount);

    modifier onlyOwner() {
        require(msg.sender == owner, "Not the owner");
        _;
    }

    constructor(uint256 _maxLimit) {
        owner = msg.sender;
        maxWithdrawLimit = _maxLimit;
    }

    // Viết hàm deposit nhận Ether ở đây
    receive() external payable {
        // Code tại đây
    }

    // Viết hàm withdraw ở đây
    function withdraw(uint256 _amount) public onlyOwner {
        // Code tại đây
    }

    // Viết hàm lấy số dư contract ở đây
    function getBalance() public view returns (uint256) {
        // Code tại đây
    }
}
Đây là kết quả từ 4 mô hình trả về:
- qwen3-4b-code-solidity.pdf
- qwen3-1.7b-code-solidity.pdf
- gemma4-e4b-code-solidity.pdf
- gemma4-e2b-code-solidity.pdf
Còn ảnh dưới là kết quả tổng hợp:
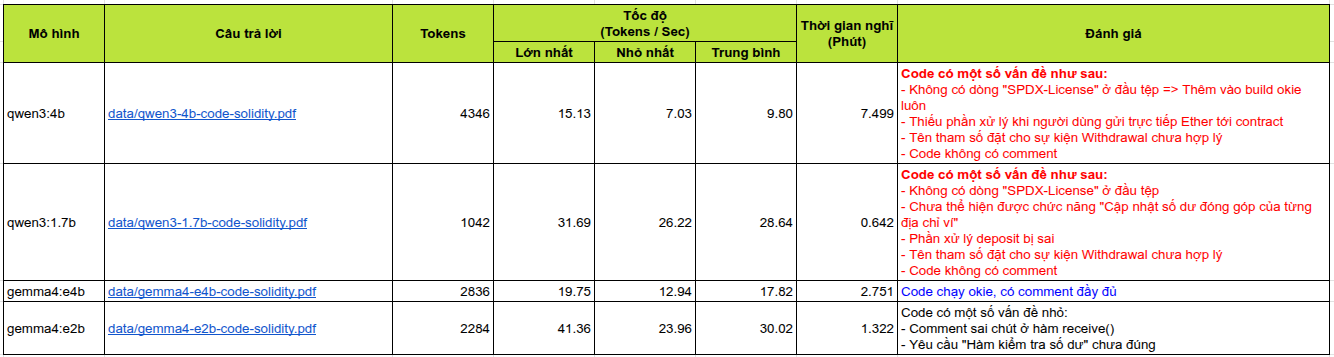
Trong bài test này, Gemma4 vẫn cho lợi thế vượt trội về cả kết quả lẫn tốc độ. Mô hình nhiều tham số sẽ cho ra kết quả tốt hơn so với mô hình ít tham số.
Đánh giá tổng hợp
Qua các bài test trên thì tôi thấy Gemma4 cho lợi thế vượt trội. Trong Gemma4 thì mô hình Gemma4 E2B tôi đánh giá cao nhất, nó rất phù hợp cho bài toán về Local AI chạy thuần CPU với RAM vừa phải và tốc độ phản hồi tốt. Còn nếu bỏ qua vấn đề RAM và tốc độ thì Gemma4 E4B là mô hình tốt nhất trong 4 mô hình.
| Model | Số lượng tham số | Kết quả tổng thể |
|---|---|---|
| Gemma4 E2B | ~2B active | ⭐⭐⭐⭐ |
| Gemma4 E4B | ~4B active | ⭐⭐⭐⭐⭐ |
| Qwen3 1.7B | 1.7B active | ⭐⭐ |
| Qwen3 4B | 4B active | ⭐⭐⭐ |
Ghi chú:
- Đây chỉ đánh giá qua một loại server xác định, với một số bài test đơn giản nên không thể nào thể hiện hết được khả năng của các mô hình.
- Số lượng bài test còn quá ít để có thể có đánh giá đầy đủ
- Bài test này chưa thể hiện được một số vấn đề:
- Hiệu năng khi context lớn
- Khả năng concurrent
- Mức độ ngốn RAM khi context tăng
- …

 Mình là lập trình viên, mặc dù cũng đã khá lớn tuổi nhưng vẫn thích Lập trình. Gần đây mình tập trung tìm hiểu nhiều hơn về Lĩnh vực Blockchain. Với kiến thức tìm hiểu được, mình muốn viết ra để lưu lại cũng như để chia sẻ cho những người quan tâm. Mong mọi người góp ý và có thể cùng mình chia sẻ nhiều kiến thức hơn cho cộng đồng.






Trả lời